

No. 12 · Manuscript compleet · AI & agents · TRAIN
ML voor agent-bouwers
Auto-training, fine-tuning en eval-loops voor LLM-gedreven systemen
Je agents roepen de hele dag modellen aan. Tijd om er een paar te bezitten.
Agents leunen voortdurend op modellen, maar de keuze om er een te bezitten blijft schimmig. ML voor Agent-Bouwers is een bouwloop voor de smalle modellen waar agents op draaien: heldere keuzes over fine-tunen versus RAG, labeling en eval-drift, zodat je wint op kosten, latentie en controle in plaats van alles te huren.
- pagina's
- 428
- hoofdstukken
- 15
- uur lezen
- ± 5
- edities
- EN · NL
- Ontwerp
- Schrijven
- Manuscript
- Productie
- Verschenen
De edities
Kindle, Paperback en Hardcover
Productieshots van de edities. Nog niet te koop — de pagina is de publieke werkversie.
-
Kindle
De digitale editie, in elke Kindle-app.
-
Paperback
Het werkexemplaar. Schrijf erin. Neem het mee naar de meeting.
-
Hardcover
De schapeditie. Donkere full-art-omslag, gemaakt om in de kamer te blijven.


Het boek
Auto-training, fine-tuning en eval-loops voor LLM-gedreven systemen
Een supportagent laat een frontier-model voor elk bericht een wachtrij kiezen. Dat kost geld, voegt latentie toe en hangt af van een leverancier die prijzen of modellen kan wijzigen. Je schrijft Python en koppelt API's. Je hebt nog geen volledige trainingspipeline gedraaid. Het debat over fine-tunen of RAG kan eindigen zonder toetsbare vraag.
Hoofdstuk 9 verzint een stillere fout om te tonen wat een totaal verbergt. De nauwkeurigheid op de validatieset lijkt acht weken lang stabiel rond de 0,89, terwijl drie factureringsgeschillen vier dagen in de verkeerde wachtrij liggen. De modelarchitectuur was niet gewijzigd, de trainingsdata evenmin. Het product wel. Een totaal kan slagen terwijl een klasse faalt, en een definitief macrogetal is geen bewijs over de klasse waarvan het falen het duurst is.
Een eigen model naast je LLM is een kandidaat, geen verbetering, tot een vergelijking op dezelfde berichten en acceptatiecriteria anders uitwijst. Het algemene model kan de juiste keuze blijven. Schrijf op waarom.
TRAIN is de lus van vijf disciplines van de auteur, en elke discipline laat artefacten na:
Wat je leert
Wat je met dit boek kunt
- Het TRAIN-protocol: Target metric, Represent data, Automate, Inspect, Narrow
- Kies fine-tunen of RAG, beheers labeling en eval-drift
- Smalle modellen die winnen op kosten, latentie en controle
Het raamwerk
TRAIN, stap voor stap
Target metric, Represent data, Automate, Inspect, Narrow
-
Target metric
-
Represent data
-
Automate
-
Inspect
-
Narrow
Uit het boek
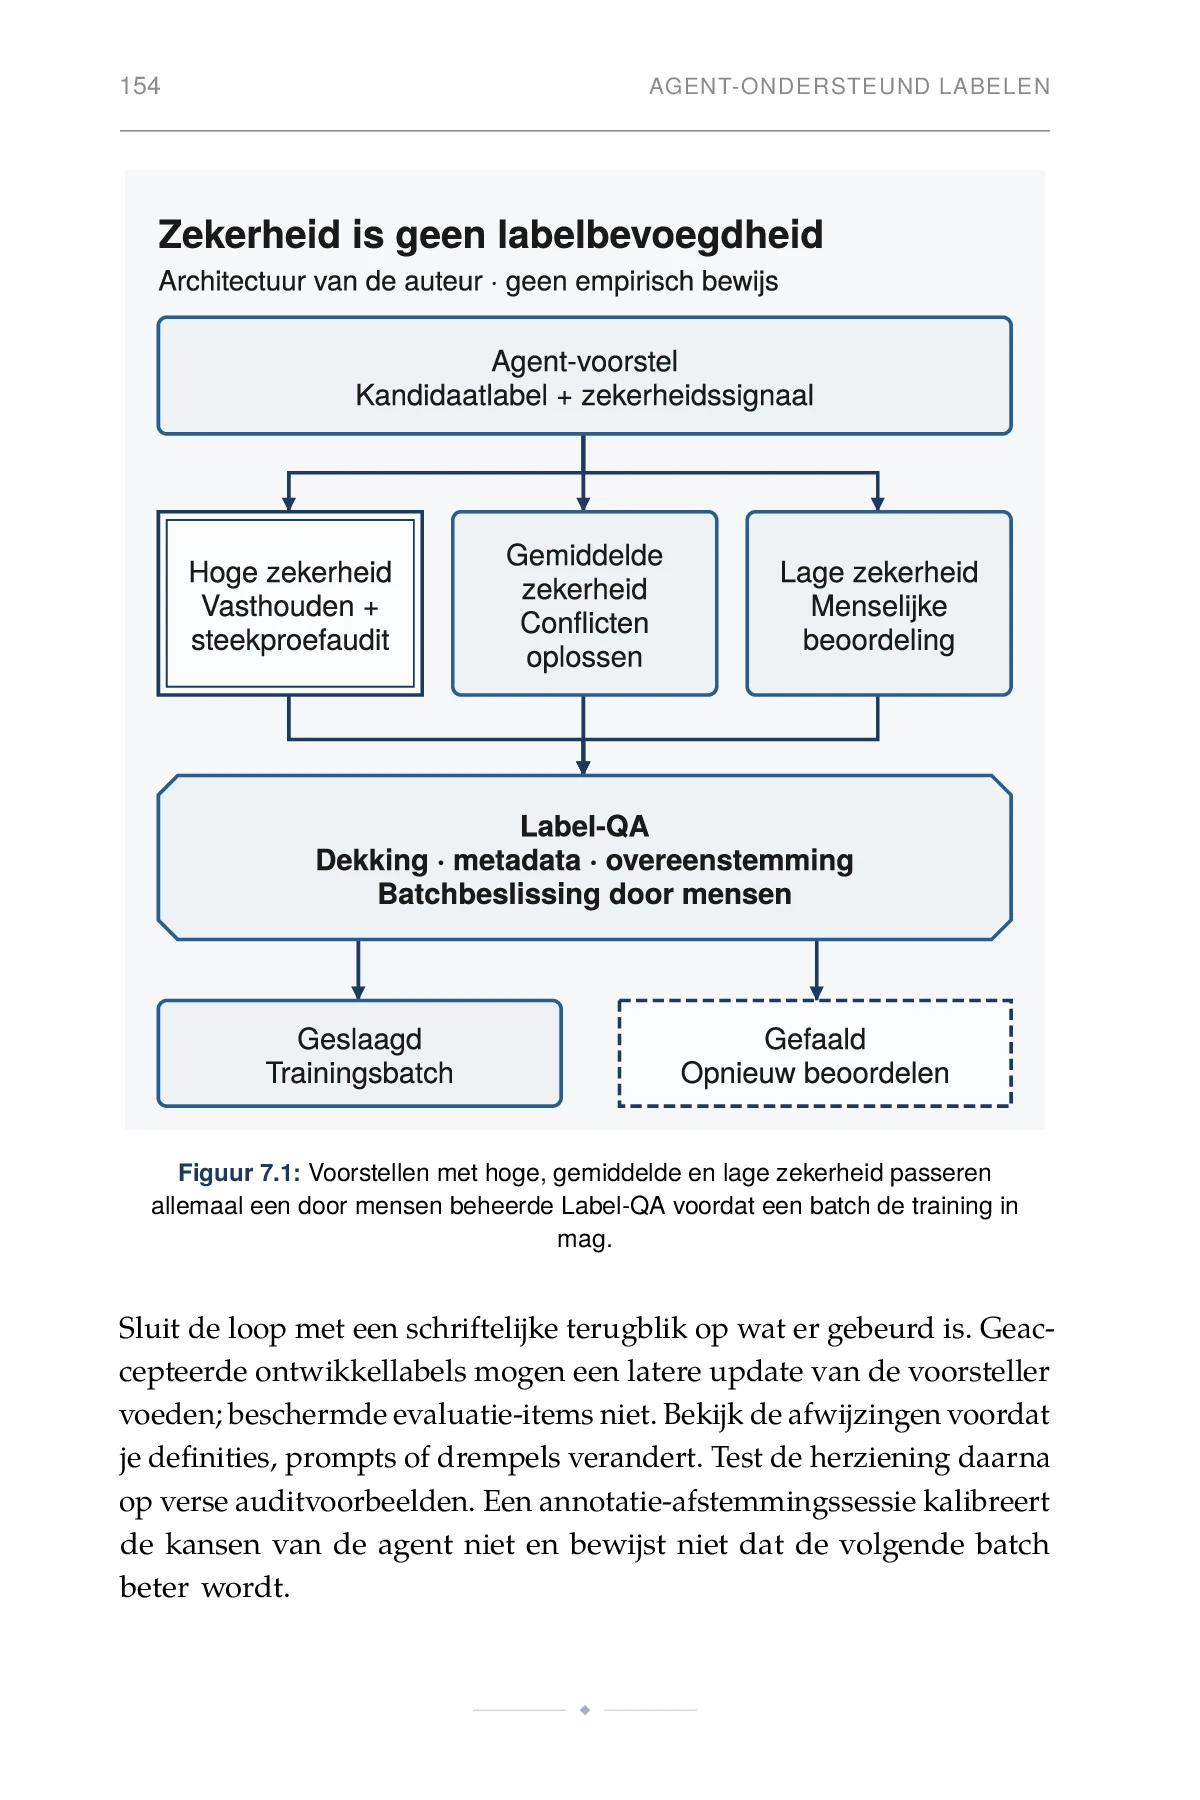
Figuur 7.1: Voorstellen met hoge, gemiddelde en lage zekerheid passeren
ML voor Agent-Bouwers, gedrukte pagina: Figuur 7.1: Voorstellen met hoge, gemiddelde en lage zekerheid passeren
Bekijk meer pagina’sKijk in het boek
Bladzijden uit de gedrukte editie.
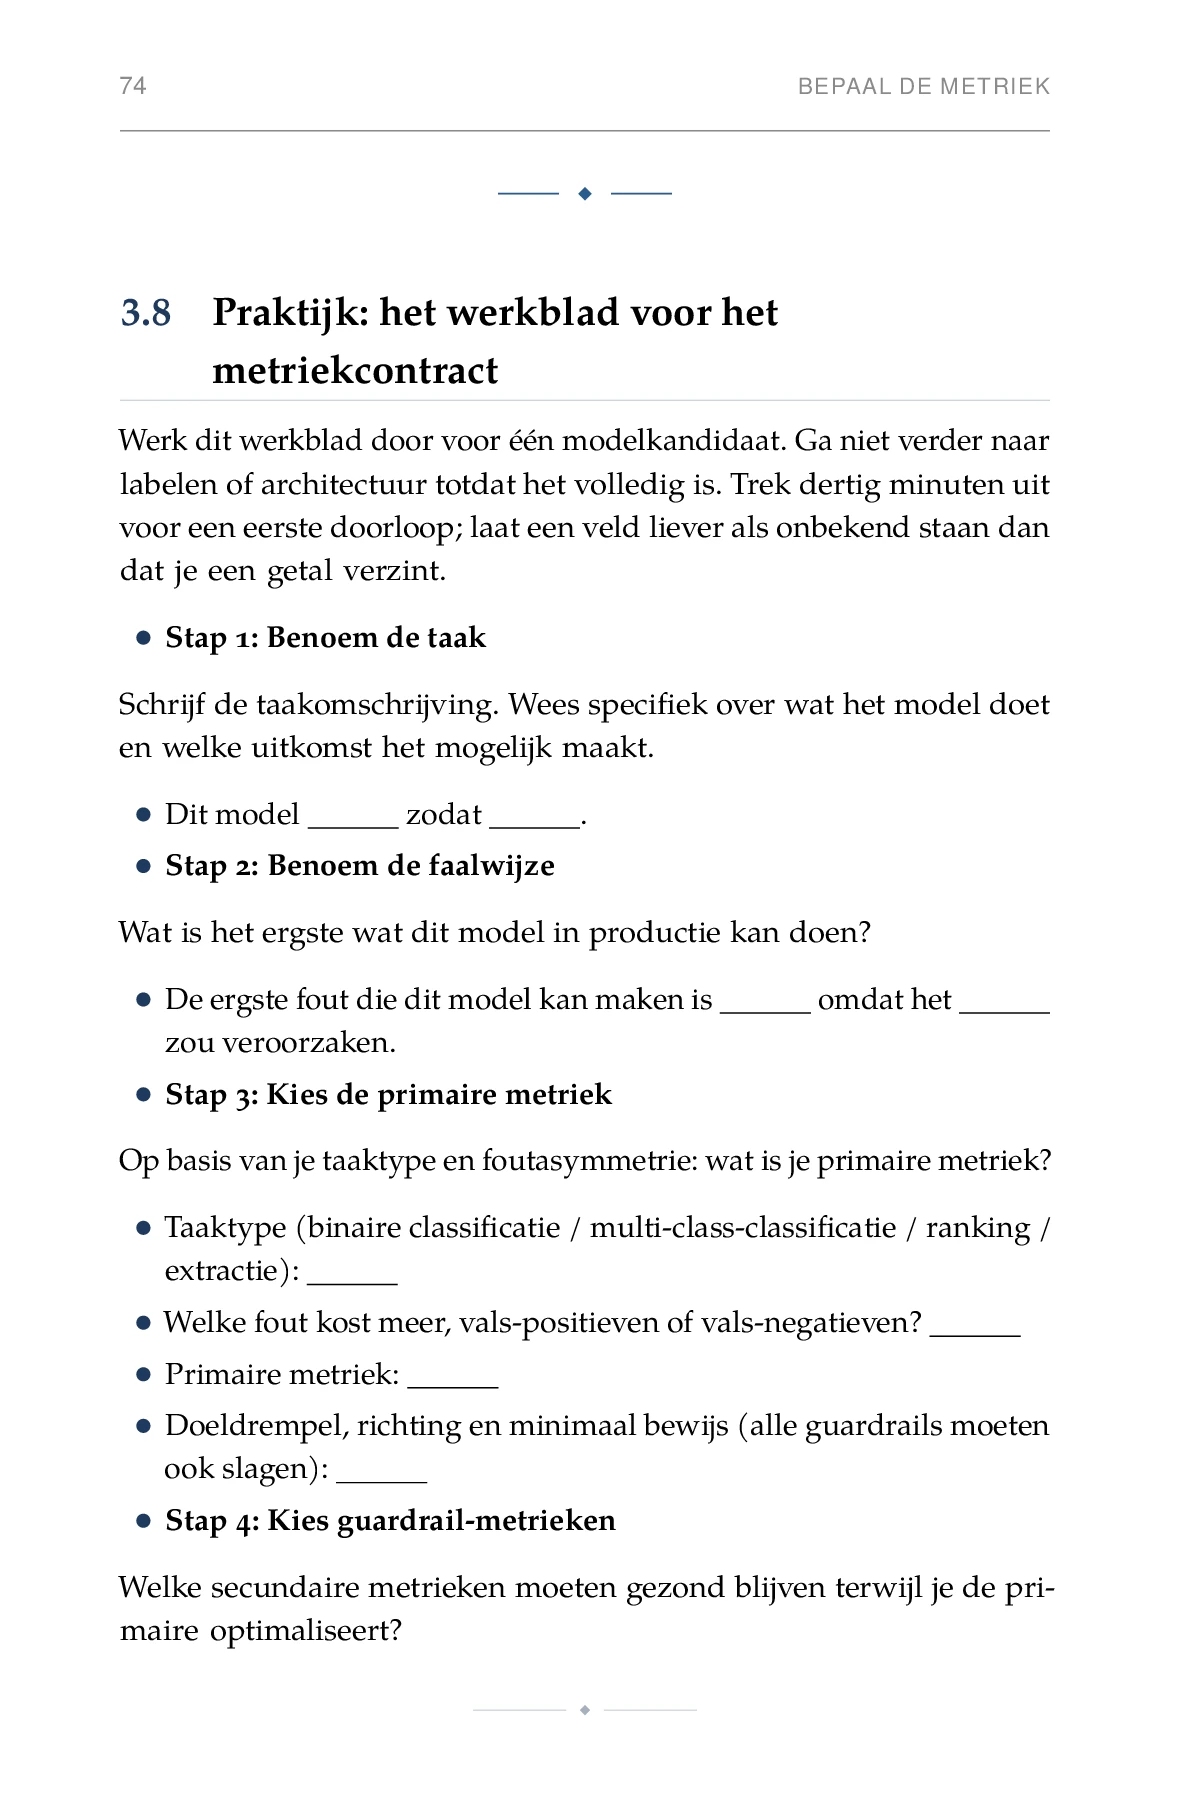
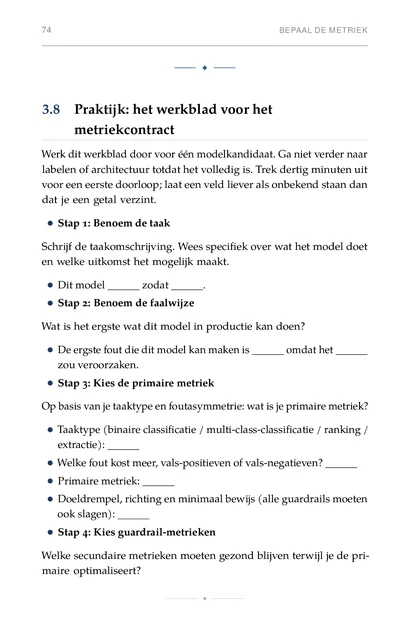 Stap 1: Benoem de taak
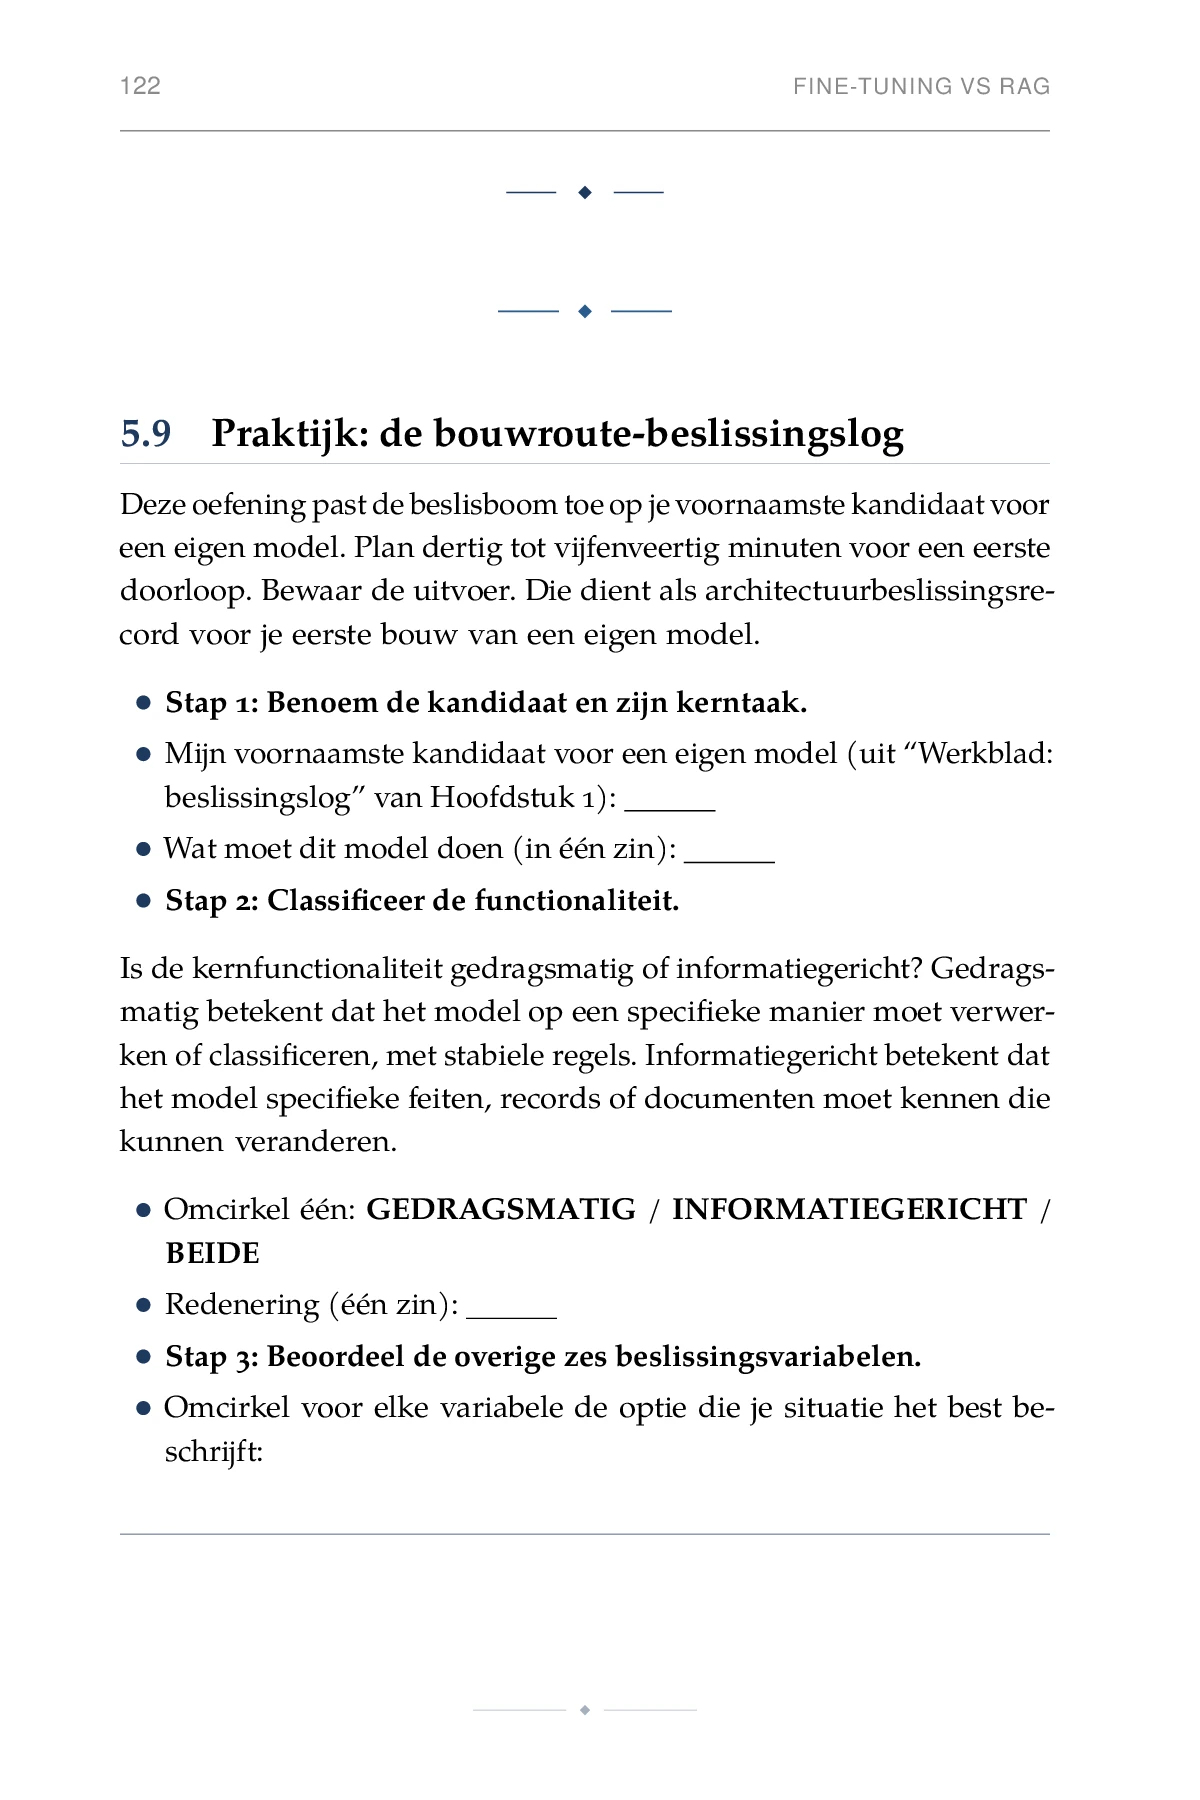
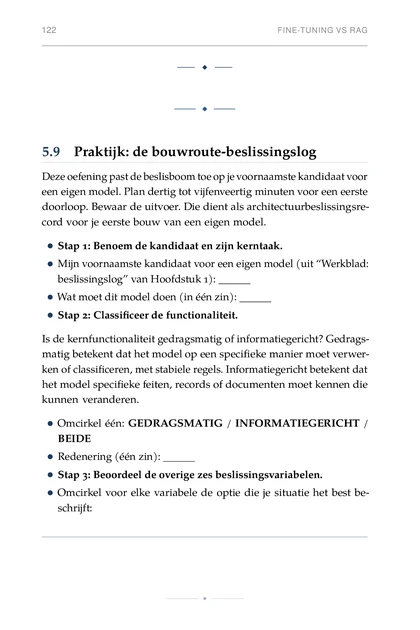 Stap 1: Benoem de kandidaat en zijn kerntaak
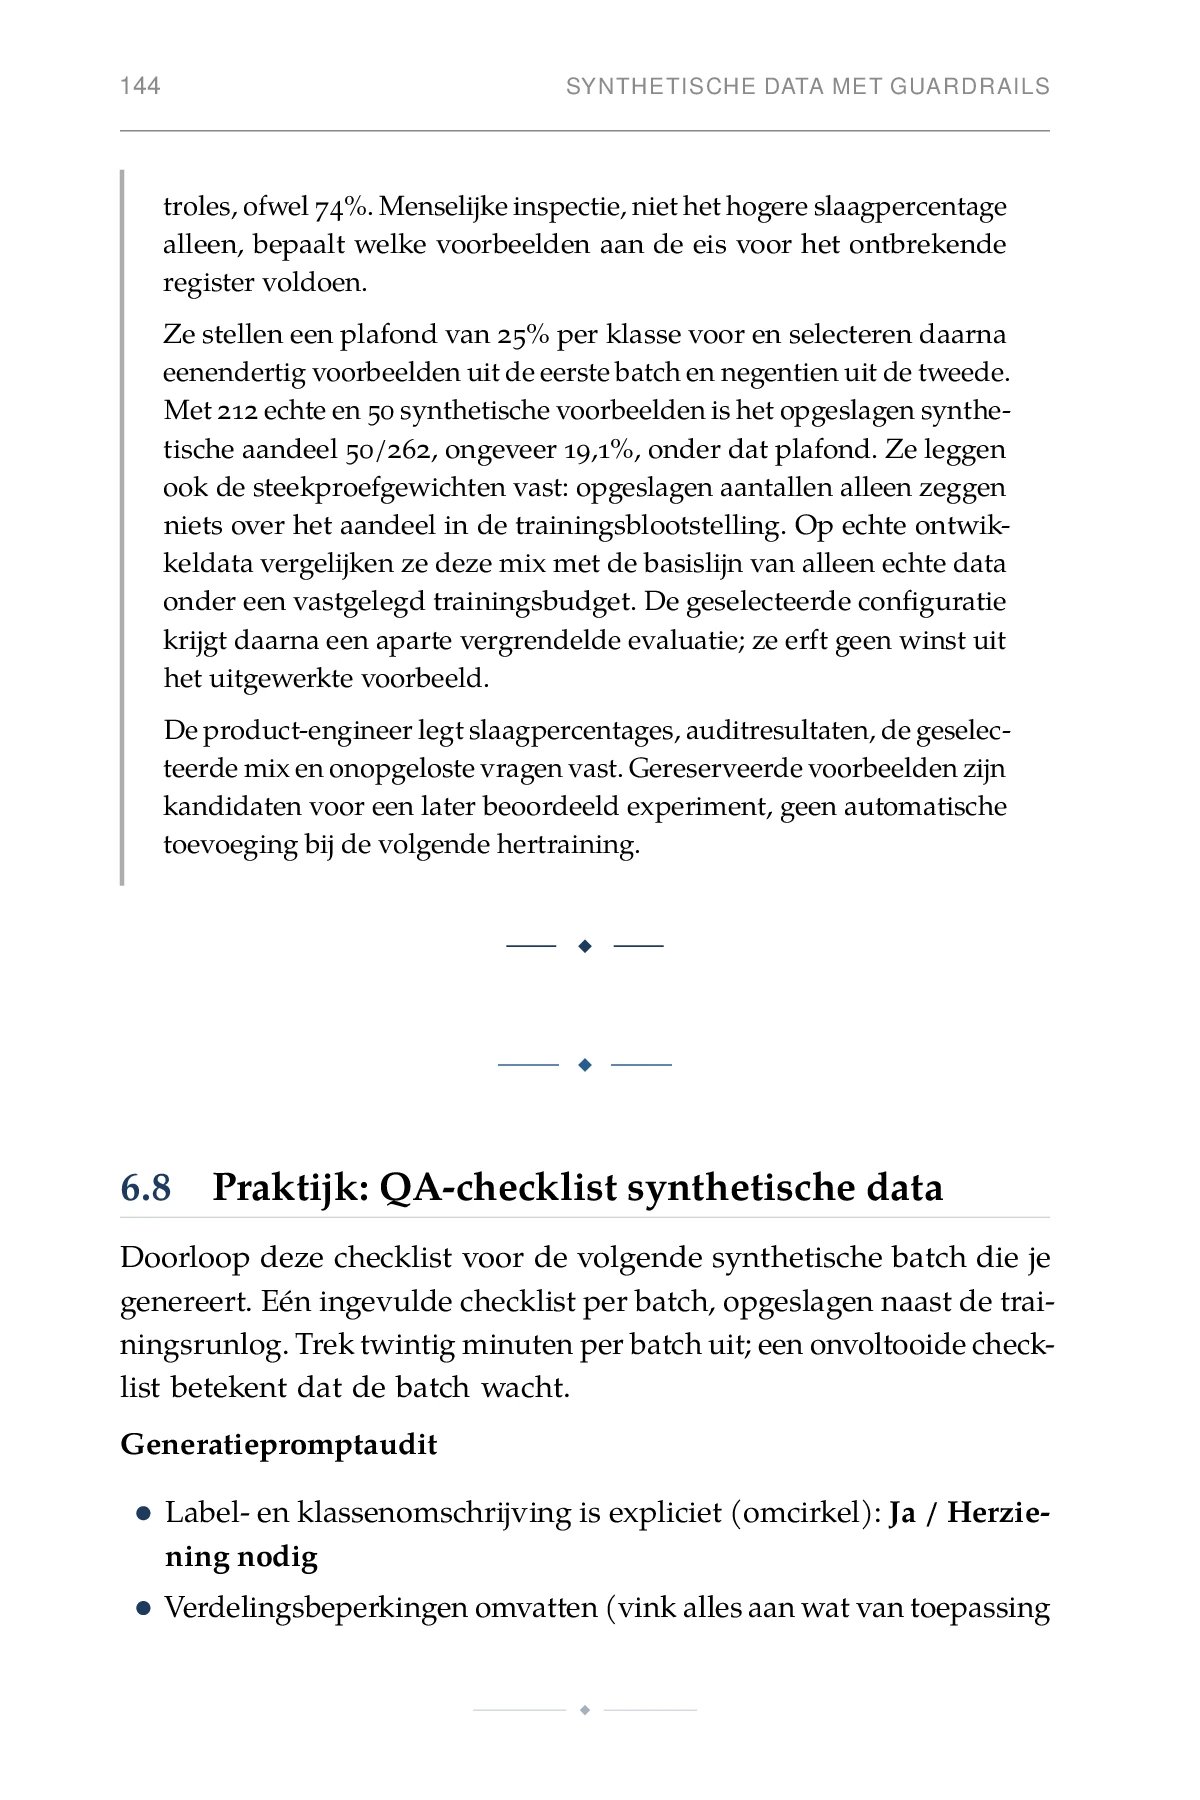
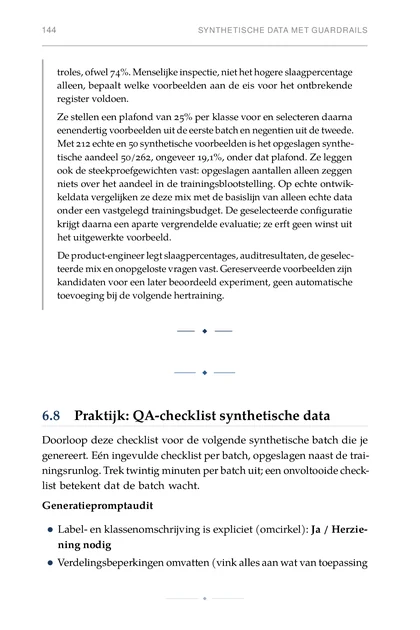 Generatiepromptaudit
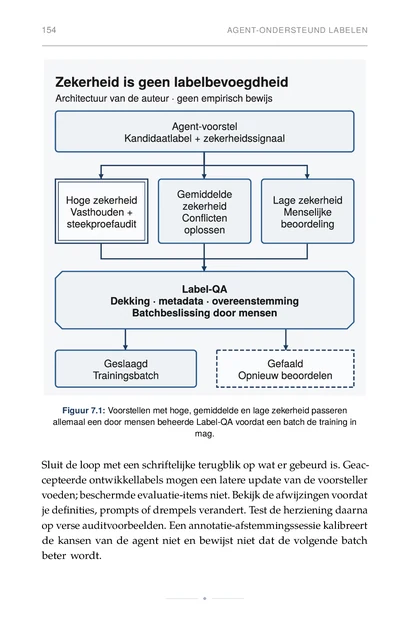 Figuur 7.1: Voorstellen met hoge, gemiddelde en lage zekerheid passeren
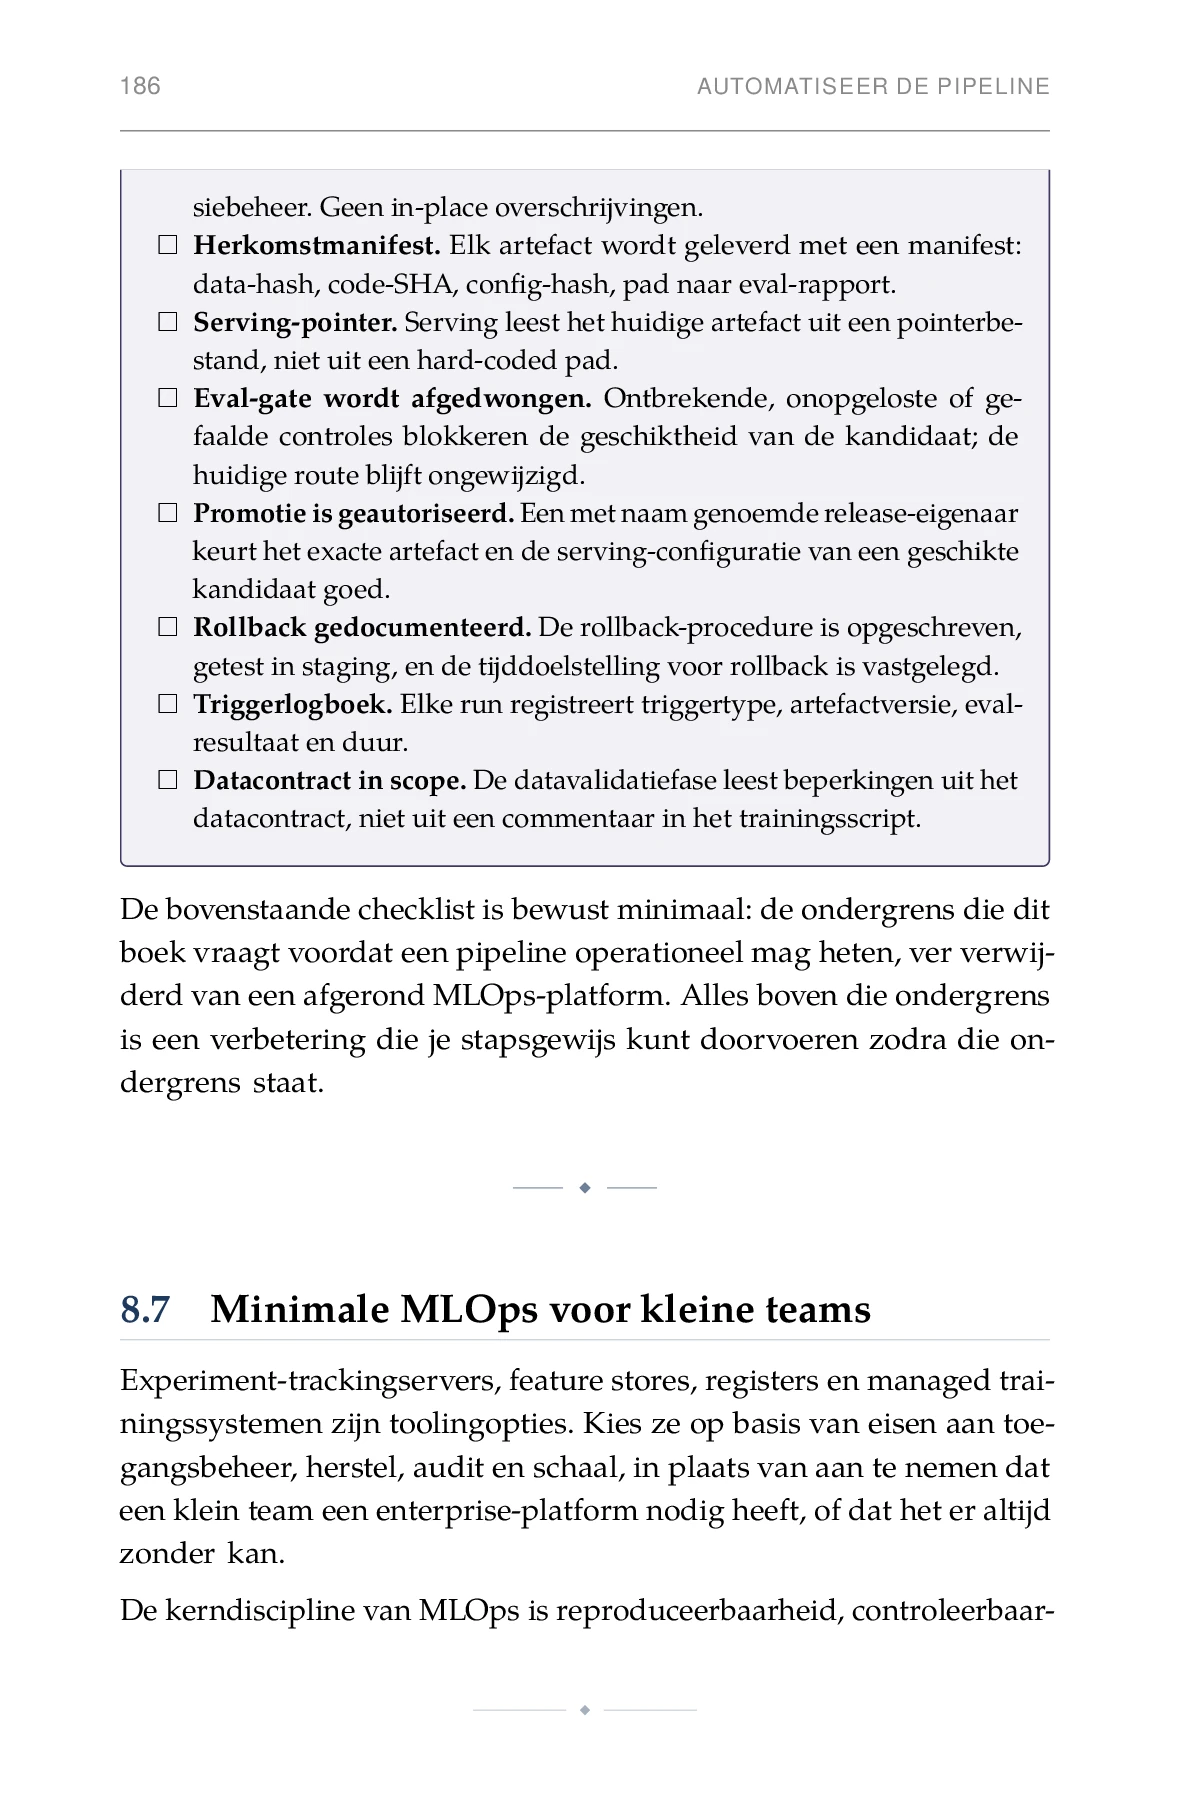
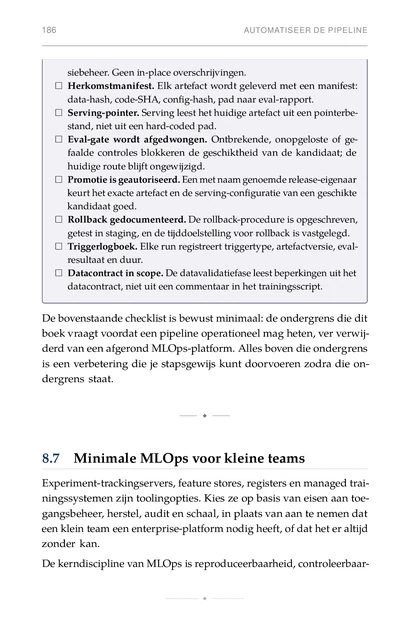 De bovenstaande checklist is bewust minimaal: de ondergrens die dit
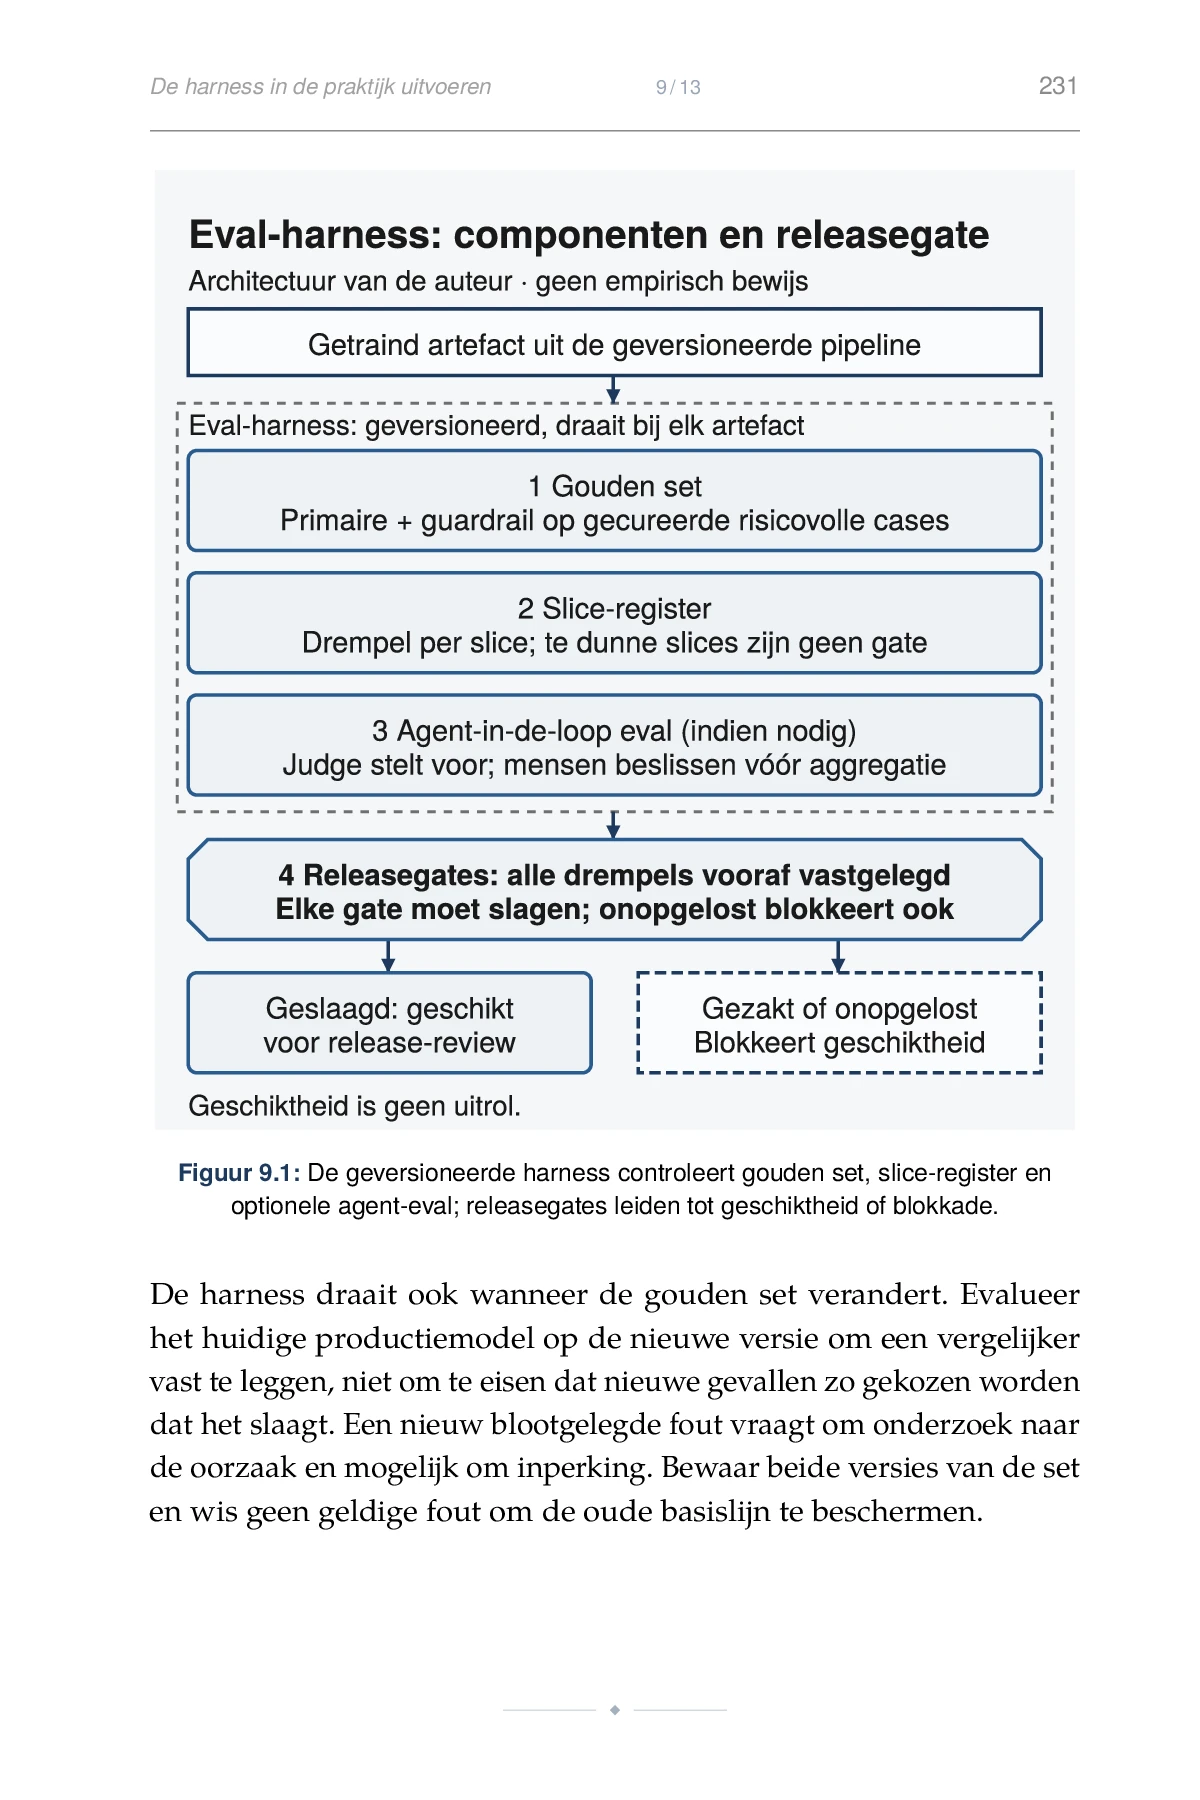
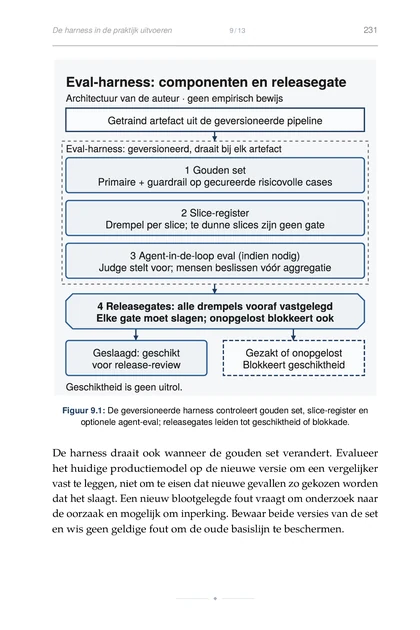 Figuur 9.1: De geversioneerde harness controleert gouden set, slice-register
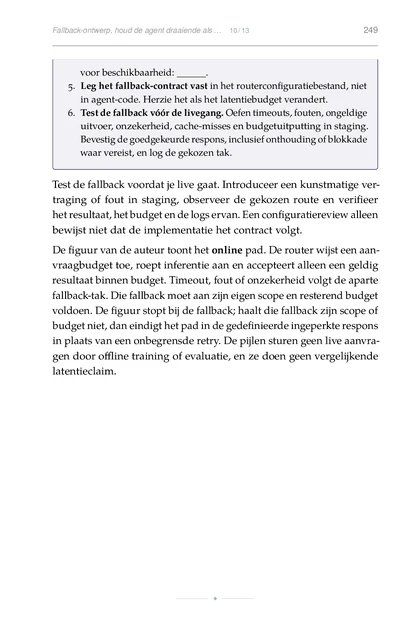 Bevestig de goedgekeurde respons, inclusief onthouding of blokkade
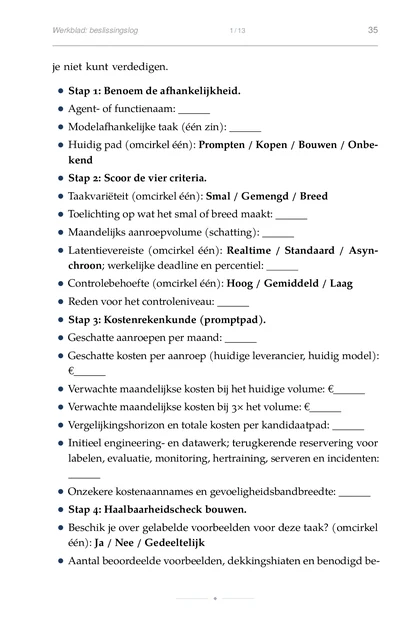 Werkblad: beslissingslog 1 13 35
De inhoud
Hoofdstuk voor hoofdstuk
Elk hoofdstuk van ML voor agent-bouwers met het motto uit de gedrukte editie, wat je erna kunt, en wanneer je het nodig hebt.
Introductie
Introductie: eigen modellen voor je agents
Voordat je een model traint, benoem je de taak die het onderhoud ervan zou rechtvaardigen.
Hoofdstuk 1
Bouwen vs kopen vs prompten
De beslissing die je blijft uitstellen, wordt al genomen: door stilzwijgen, door inertie, door degene die het architectuurdocument schreef.
Hoofdstuk 2
TRAIN, overzicht
Een lab-experiment loopt door totdat je er genoeg van hebt. Een productlus loopt door totdat het product er geen behoefte meer aan heeft.
Hoofdstuk 3
Bepaal de metriek
Een model dat beoordeeld wordt zonder metriek is een kompasnaald zonder noorden. Het draait rond, stopt ergens, en wijst nergens in het bijzonder naartoe.
Hoofdstuk 4
Representeer de data
Schrijf, voordat je traint, op wat elke rij betekent, waar ze vandaan komt en welke beslissingen ze mag sturen.
Hoofdstuk 5
Fine-tuning vs RAG
Vraag welke beperking opgelost moet worden, en vergelijk dan wat elke route kost om dat te doen.
Hoofdstuk 6
Synthetische data met guardrails
Gegenereerde voorbeelden zijn kandidaten, geen onafhankelijk bewijs dat hun labels kloppen.
Hoofdstuk 7
Agent-ondersteund labelen
Een voorstel met hoge zekerheid blijft een voorstel. Bepaal wie het in een trainingslabel mag omzetten.
Hoofdstuk 8
Automatiseer de pipeline
Een trainingsscript dat je met de hand uitvoert, is handwerk. Een pipeline die op een trigger loopt, is infrastructuur.
Hoofdstuk 9
Eval-harnesses voor agent-ML
Automatisering zonder regressietests versnelt het falen en geeft het bovendien het vertrouwen van een werkende pipeline mee.
Hoofdstuk 10
Uitrollen naast de LLM-router
Een model dat alleen in een notebook bestaat, maakt nog geen deel uit van het agentsysteem. Uitrollen is de beslissing die een experiment verandert in infrastructuur.
Hoofdstuk 11
Inspecteer drift
Elk model is een foto van de wereld op het moment dat je het trainde. De vraag is of de wereld sindsdien is veranderd.
Hoofdstuk 12
Smalle-scopediscipline
Schrijf de grens van het model op voordat je vraagt wat het nog meer zou kunnen.
Hoofdstuk 13
Casestudy's over routing, reranking en moderatie
Drie hypothetische builds maken de beslissingen concreet. Hun resultaten zijn geen bewijs voor die van jou.
Conclusie
Conclusie: TRAIN op de kalender
Een checkpoint eindigt met een beslissing, een eigenaar en een datum, ook wanneer de beslissing is om niet te trainen.
Voor wie
Voor wie dit boek is geschreven
Drie uitwerkingen volgen dezelfde structuur, van taak tot servingbeslissing: intent-router, cross-encoder-reranker, moderatiefilter. Je begint met een architectuurvoorkeur en eindigt met een vastgelegde vergelijking.
TRAIN is een operationeel voorstel van de auteur, geen gevalideerde interventie, en de scenario's tonen geen gemeten voordeel voor eigen modellen. Een verdedigbare beslissing om niet te bouwen is een geslaagd gebruik van dit boek.
Edities
Edities en specificaties
| Editie | Formaten | Hoofdstukken | Pagina's | Leestijd | ISBN (paperback) |
|---|---|---|---|---|---|
| Nederlands ML voor agent-bouwers | In productie | 15 | 428 | ± 5 uur | — |
| Engels ML for Agent Builders | In productie | 15 | 410 | ± 5 uur | — |
Beide edities zijn zelfstandig geschreven. De Nederlandse tekst is geen machinevertaling van de Engelse. · Formaat: 6x9″
Veelgestelde vragen
Wat lezers meestal willen weten
Waar gaat ML voor agent-bouwers over?
TRAIN helpt agentbouwers bepalen wanneer eigen ML, fine-tuning, retrieval, evaluatie en driftmonitoring de operationele kosten waard zijn. De ondertitel luidt: Auto-training, fine-tuning en eval-loops voor LLM-gedreven systemen.
Wat houdt het TRAIN-raamwerk in?
TRAIN: Target metric, Represent data, Automate, Inspect en Narrow. Target metric, Represent data, Automate, Inspect, Narrow
Is er ook een Engelse editie?
Ja. De Engelse editie heet ML for Agent Builders en is een zelfstandig geschreven editie, geen machinevertaling. Die verschijnt in dezelfde productielijn.
Hoe lang is ML voor agent-bouwers?
Deze editie telt 15 hoofdstukken, 428 pagina's in druk en ongeveer 5 uur lezen.
Voor wie is ML voor agent-bouwers geschreven?
TRAIN is een operationeel voorstel van de auteur, geen gevalideerde interventie, en de scenario's tonen geen gemeten voordeel voor eigen modellen. Een verdedigbare beslissing om niet te bouwen is een geslaagd gebruik van dit boek.
Het productiesysteem
Hoe dit boek is gemaakt
Elke titel doorloopt dezelfde gecontroleerde productielijn: onderzoek met bronregistratie, een bewijzenregister per claim, structuurreview, feitencontrole, red-team-kritiek en een tweetalige eindredactie. AI-agents doen specialistisch werk binnen die poorten; het oordeel, de stem en de verantwoordelijkheid blijven menselijk.
- Claims staan in een bewijzenregister met bron en gradatie voordat ze in de tekst komen
- Nederlands en Engels zijn twee zelfstandige edities, geen vertaling van elkaar
- Elk hoofdstuk passeert leesbaarheids-, ritme- en stijlpoorten voordat het gezet wordt


